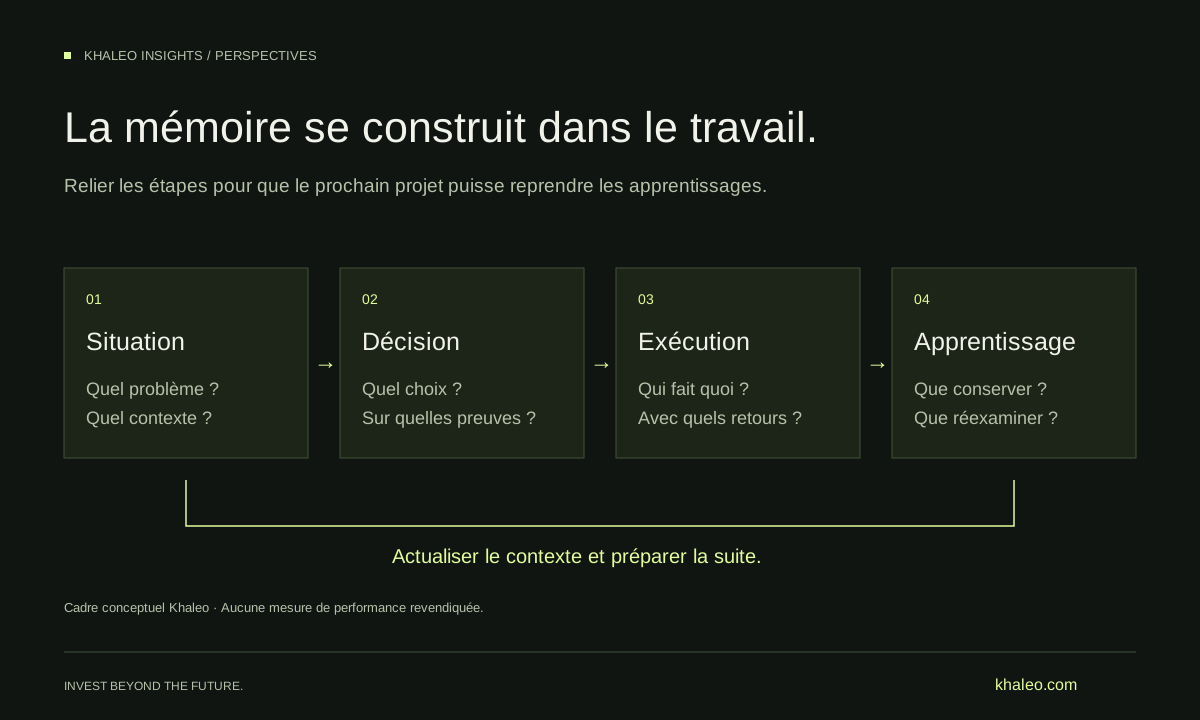
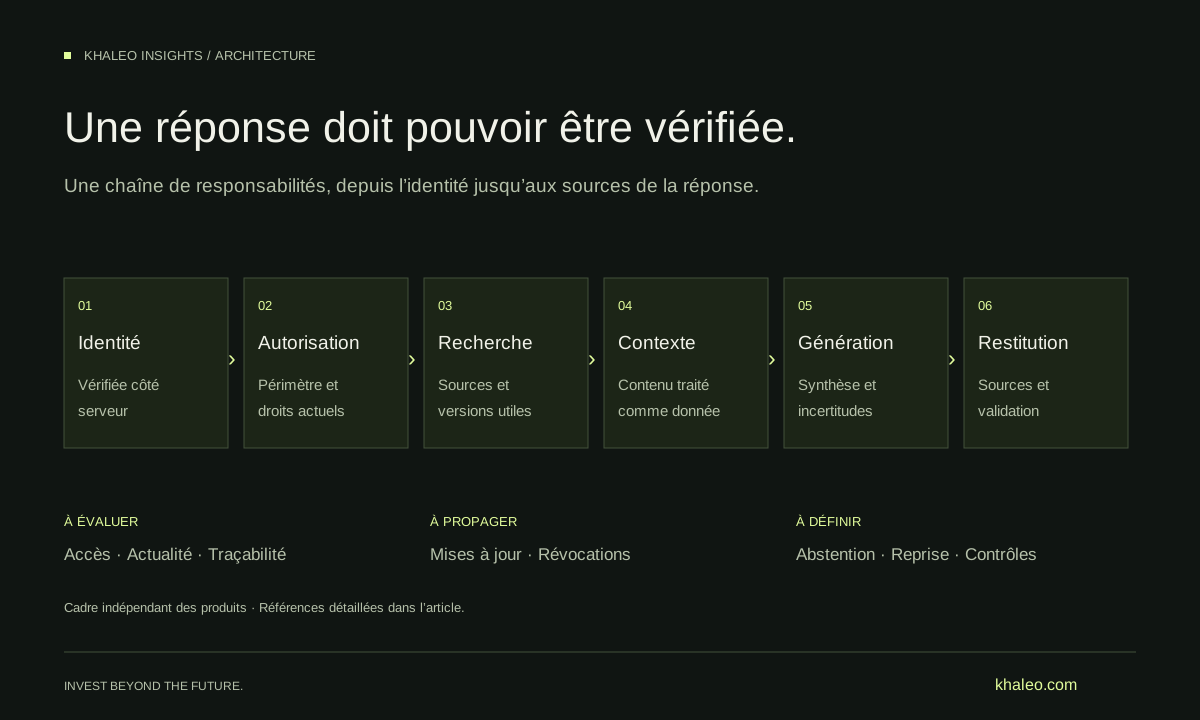
- Définir une unité de valeur métier plutôt qu’un volume de génération.
- Inclure orchestration, contrôle, reprises et exploitation dans le coût complet.
- Construire la différenciation dans le workflow, les données utilisables et la confiance.
Une baisse du prix d’inférence n’est pas un modèle économique.
L’AI Index 2025 de Stanford HAI rapporte une baisse de plus de 280 fois du coût d’inférence pour un niveau de performance comparable à GPT-3.5 sur MMLU entre novembre 2022 et octobre 2024. Ce constat historique concerne un seuil de benchmark et une période définie. Il ne décrit ni les prix actuels de tous les modèles ni le coût complet d’un produit.
La distinction change les décisions. Un modèle moins cher peut ouvrir de nouveaux usages, mais les appels supplémentaires, la recherche documentaire, les vérifications et le support peuvent absorber une partie du gain. Une réponse à très faible coût qui exige une longue correction n’est pas nécessairement économique. Le point de départ doit être le service rendu : qu’est-ce que l’utilisateur peut désormais accomplir, avec quel niveau de fiabilité et quelle charge résiduelle ?
Définir l’unité que le client reconnaît.
Un produit peut facturer des sièges, des volumes ou des résultats. Quel que soit le choix commercial, l’équipe a besoin d’une unité interne pour piloter la valeur et les coûts. « Dossier correctement préparé », « demande résolue » ou « document validé » sont plus proches du travail réel que « nombre de tokens ». Leur définition doit cependant inclure un périmètre et une règle d’acceptation.
Une demande peut être générée puis refusée ; un document peut être validé après trois reprises. L’économie doit compter l’ensemble du parcours nécessaire au résultat accepté. Pour éviter d’embellir les chiffres, les échecs, abandons et contrôles doivent rester dans le numérateur des coûts. Seuls les résultats satisfaisant le critère convenu alimentent le dénominateur.
Il faut ensuite regarder les cohortes d’usage. Les premiers utilisateurs peuvent concentrer les tâches simples ou bénéficier d’une assistance rapprochée. Étendre le produit à une clientèle plus diverse modifie la complexité, le support et la fréquence des exceptions. Une bonne économie sur un pilote ne prouve pas encore sa robustesse à l’échelle.
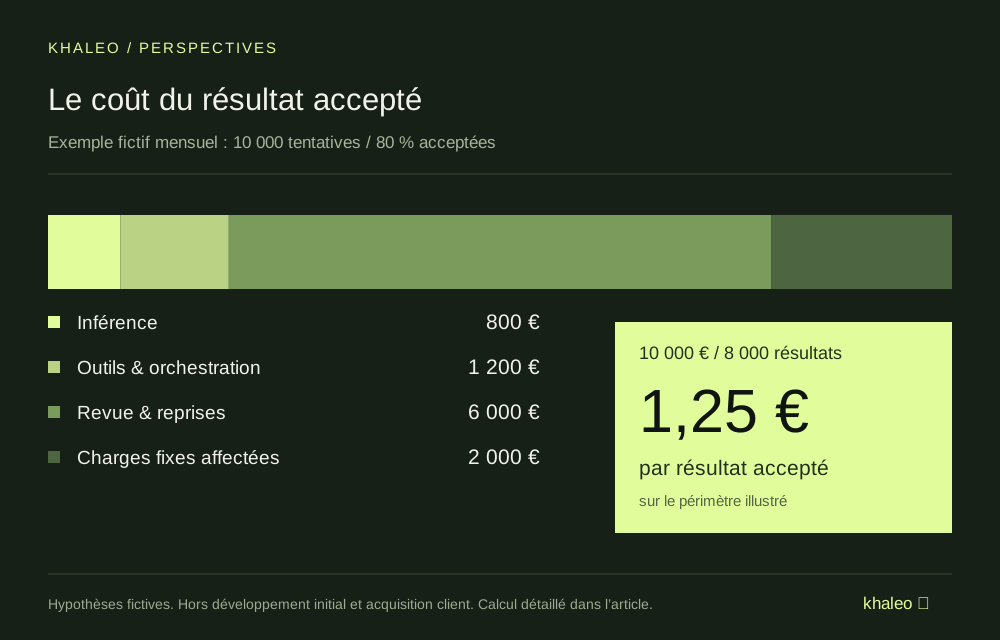
Exemple entièrement fictif : 10 000 tentatives par mois, 80 % acceptées, 0,08 € d’inférence + 0,12 € d’outils + 0,60 € de revue et reprises par tentative, 2 000 € de charges fixes mensuelles affectées. Coût du périmètre : 10 000 € / 8 000 résultats acceptés = 1,25 €. Hors développement initial et acquisition client.
Télécharger l’infographie (SVG) ↓Le coût complet a plusieurs étages.
L’inférence est la partie visible. L’orchestration ajoute recherche, appels d’outils et traitement des données. Le contrôle réunit validation automatisée et revue humaine. Les reprises couvrent les tentatives supplémentaires et les corrections. L’exploitation comprend la supervision, les incidents et la maintenance des évaluations. Selon le produit, d’autres coûts pertinents doivent être ajoutés.
Notre simulation distingue volontairement coût variable et charges fixes affectées au mois. Elle calcule un coût par résultat accepté en divisant les dépenses du périmètre par le nombre de résultats répondant aux critères. C’est un outil de raisonnement, avec des hypothèses fictives modifiables, pas une estimation de marché. Les coûts de développement initial et d’acquisition client restent à ajouter pour une lecture complète de rentabilité.
Un indicateur complémentaire utile est le coût des cas difficiles. Une moyenne favorable peut masquer une longue traîne d’exceptions qui mobilise les personnes les plus rares. Les limites de produit, les refus explicites et les parcours d’escalade peuvent améliorer cette économie davantage qu’une nouvelle optimisation de prix par appel.
Quel coût par résultat accepté ?
Modifiez les hypothèses fictives. Ce calcul de périmètre ne constitue pas une estimation de rentabilité complète.
La confiance est une fonction du produit.
Un logiciel AI natif ne se réduit pas à placer une conversation devant une base de données. Il organise un travail : préparation, suggestion, vérification, action et retour. L’interface doit donner à l’utilisateur des moyens de juger le résultat : provenance utile, distinction entre faits et hypothèses, statut de validation et possibilité de correction.
Une citation affichée n’est pas à elle seule une garantie ; elle doit réellement permettre de remonter à l’élément qui soutient l’affirmation. De même, une validation humaine ne suffit pas si le volume rend la revue superficielle. La conception doit rendre le contrôle praticable, en exposant les changements importants et les zones d’incertitude plutôt qu’en transférant toute la charge de vigilance à l’utilisateur.
La boucle de retour est un actif lorsque l’équipe sait l’exploiter. Une correction doit pouvoir devenir un cas d’évaluation, une clarification du périmètre ou une amélioration du parcours. Accumuler des interactions sans droits clairs, sans qualité de données et sans méthode d’apprentissage ne crée pas automatiquement cet avantage.
Construire ce qui reste quand les modèles progressent.
Si une amélioration générale des modèles rend une fonction facile à reproduire, la différenciation doit se situer ailleurs : compréhension du métier, intégration au travail, distribution, données utilisables, simplicité de contrôle ou qualité de service. Ces dimensions sont moins visibles dans une démonstration, mais déterminent souvent la continuité de l’usage.
La bonne question d’architecture est donc double. Peut-on changer de composant sans perdre la connaissance métier ? Peut-on tester une nouvelle version sans fragiliser les parcours existants ? Séparer les règles, les accès, les évaluations et la logique du produit réduit la dépendance à un fournisseur donné, sans garantir qu’une substitution sera immédiate ou gratuite.
Notre conviction : l’intelligence intégrée devient une force quand elle améliore à la fois l’expérience, la fiabilité et l’économie du résultat. Le modèle ouvre le possible. Le produit décide si ce possible devient un service que l’on adopte et que l’on peut durablement exploiter.
Une perspective, avec ses appuis.
Analyse originale Khaleo, publiée le 29 octobre 2026. Les sources externes soutiennent les constats explicitement cités ; les propositions et cadres Khaleo relèvent de notre analyse. Les dates et limites des observations sont conservées. Les exemples fictifs sont identifiés comme tels.
- Stanford HAI — AI Index 2025, synthèse ↗
- Stanford HAI — AI Index 2025, chapitre 1, coûts d’inférence ↗
Les éléments chiffrés ne constituent pas une prévision de résultat pour une autre organisation. Les cadres sont à adapter au contexte et aux expertises nécessaires.
Appliquons cette réflexion à votre contexte